2026年5月18-19日,由高工人形机器人、高工咨询主办的2026(第三届)高工人形机器人技术应用峰会在上海成功举办。本届峰会以“当具身智能开始冲入现实”为主题,聚焦具身智能数据与模型核心议题,汇聚产学研大咖,共同探讨具身智能从技术走向落地的关键路径。
图:2026高工人形机器人技术应用峰会
作为具身智能领域的创新力量,星源智机器人成功斩获「2026具身智能产业落地标杆奖」,公司联合创始人何嘉伟发表题为《具身大模型走向何处:VLA 还是世界模型?》的主题演讲,分享当前具身智能模型三大范式、具身大模型的演进方向与技术路径,为行业路线探索提供重要参考。
星源智机器人成功斩获「2026具身智能产业落地标杆奖」
星源智凭借在具身大模型领域的技术突破与场景落地能力,成功斩获「2026具身智能产业落地标杆奖」。该奖项由高工人形机器人发起,旨在表彰在真实场景实现部署应用、具备实际交付能力与商业化价值的标杆企业。荣获该奖是对星源智机器人技术实力与落地应用的高度认可。
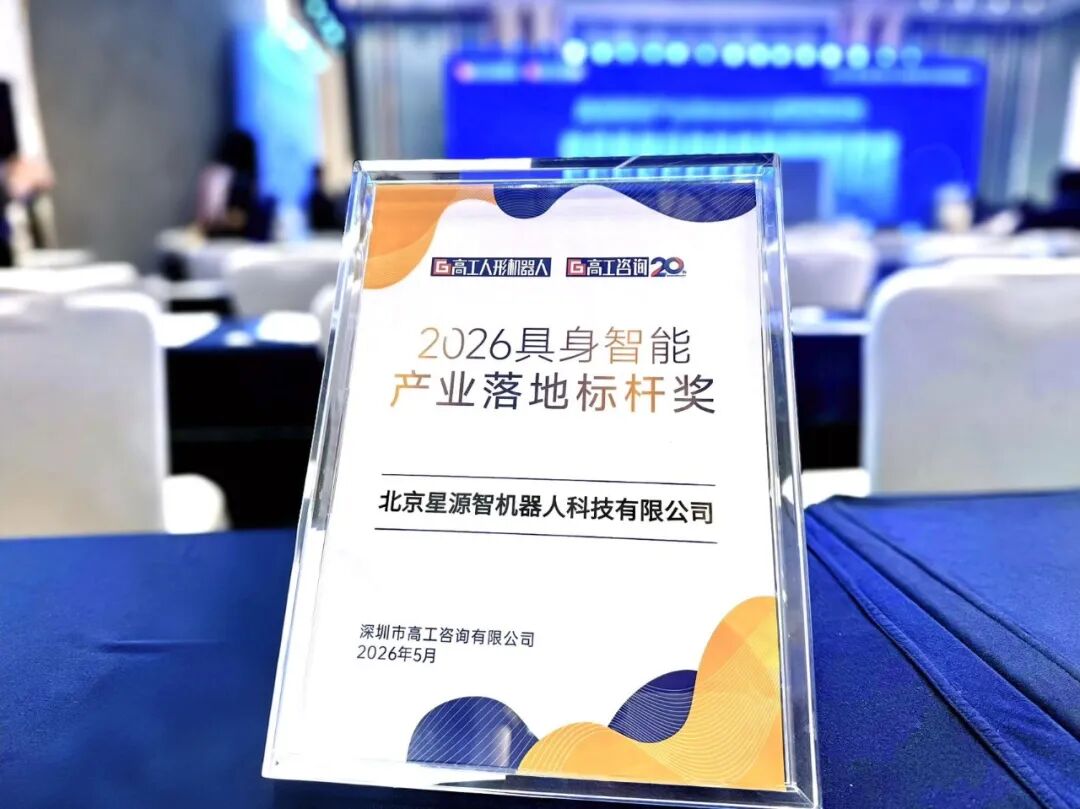
图:星源智「2026具身智能产业落地标杆奖」奖牌
《具身大模型走向何处:VLA还是世界模型?》
随着具身智能快速发展,大模型成为行业发展核心动力,但行业仍存在不少发展瓶颈:模型适配真实场景能力不足,虚实融合难度较大,各类技术路线也各有局限……当下具身大模型领域方向各异,业内围绕VLA与WAM路线,以及分层模型与端到端架构等不同发展模式的探讨不断,同时也在探索。
星源智机器人联合创始人何嘉伟在《具身大模型走向何处:VLA还是世界模型?》的演讲中,总结了3个当前具身模型的主要范式极其挑战:
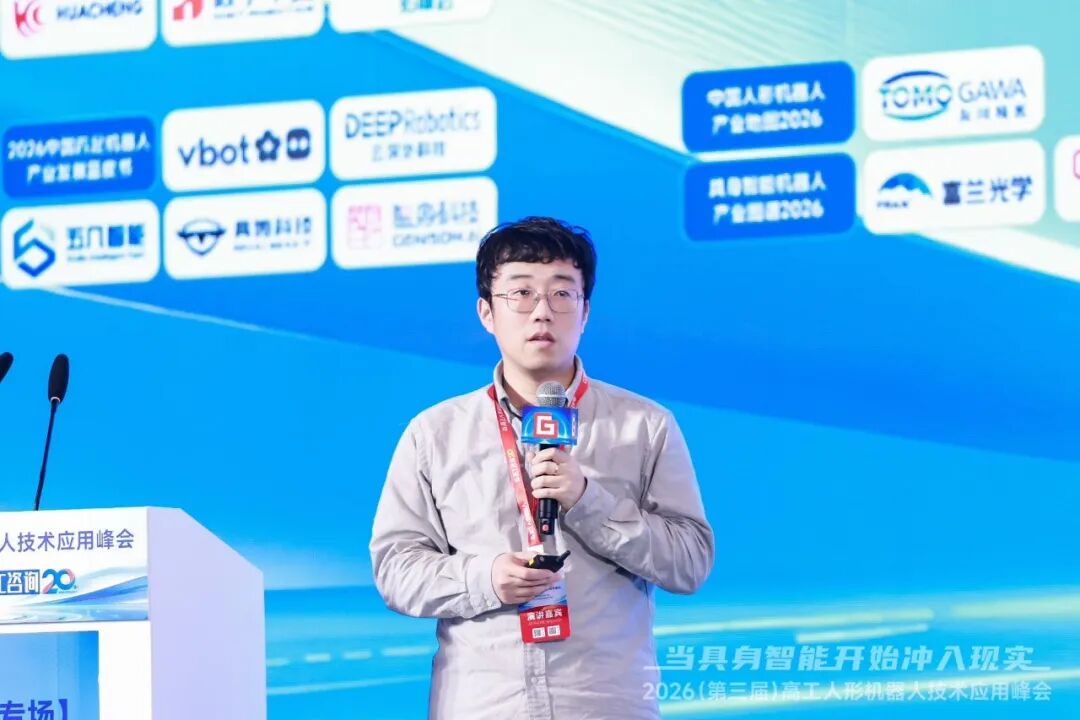
图:星源智联合创始人何嘉伟演讲
VLA模型(以OpenVLA为代表):帮助机器人实现从语言和视觉到动作的端到端能力,即机器人可以根据指令做出动作,但这更像是“把见过的动作模式调出来”,而非真正理解世界;
AC-WM模型(以LeWorldModel为代表):机器人通过动作条件(action condition)学习latent dynamics,即从环境上下文(contex)预测推理出target representation。但还是在固定的数据集上学习,而非真实世界闭环,以及持续修正世界理解;
WAM世界动作模型(以LingBot-VA为代表):机器人开始具备action后果预测的能力,即保留视频生成模型的预训练能力。但大多仍是离线与训练主导,把视频生成模型当作预训练底座,向机器人控制适配,本质还是行为克隆。
他指出,具身智能正从“视觉到动作的条件反射式VLA”,迈向“先想象世界、再生成动作” 的WAM时代,模型核心缩放定律从动作数据转向世界动力学数据(World Dynamics Data)。
针对世界模型的构建路线,何嘉伟强调:并非单纯Sora/WAN式视频生成模型,而是以NVIDIA Cosmos、DeepMind Dreamer/Genie、Meta V-JEPA为代表的可交互物理世界模型,通过扩散模型或潜在技能动作解码器,将模型想象的未来场景转化为机器人真实可执行动作,真正实现机器人对物理世界的理解与自主决策。
本次峰会亮相与获奖,是星源智机器人在具身智能领域的又一重要里程碑。未来,星源智将持续深耕具身大模型与世界模型技术,推动技术从实验室走向真实场景,助力具身智能产业规模化落地,让机器人真正走进物理世界、创造实际价值。